 Sweet Pal
Il costo di una chat AI si decide quasi tutto prima che il modello scriva una parola. In un turno tipico il modello legge decine di migliaia di token di istruzioni e ne scrive qualche decina di risposta; se lavora in più giri, rilegge tutto a ogni giro. Per abbassare la bolletta conviene quindi far leggere meno, una volta sola, e riusare dalla cache quello che non cambia. Il resto, scegliere il modello giusto per ogni lavoro, viene dopo.
Lo raccontiamo con i numeri di Sweet Pal, un compagno per chi vive con il diabete di tipo 1 in cui la chat è il cuore dell'app. Sono numeri piccoli e recenti, presi dai nostri log e dal nostro banco di prova: valgono come ordini di grandezza, non come legge.
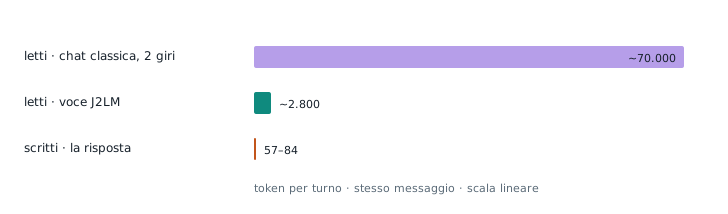
Il prompt della chat di Sweet Pal contiene chi è Sweet Pal, le regole di sicurezza, la conoscenza clinica di base e il manuale di 31 strumenti: registrare un pasto, mostrare una curva, leggere il diario, impostare un promemoria. Ogni messaggio della persona arriva al modello dentro tutto questo. La risposta, invece, è breve: nelle nostre misure una risposta della voce scrive in mediana tra 57 e 84 token. Il rapporto fra letto e scritto non è vicino a uno a uno, è di decine, a volte centinaia, a uno. Anche se un token scritto costa più di uno letto (sul modello principale che usavamo a fine settembre, a listino, 66 centesimi per milione in uscita contro 22 in ingresso), la massa sta in ingresso.
Ottimizzare la lunghezza delle risposte, quindi, serve alla persona che legge ma sposta poco il conto. Il conto si sposta riducendo quello che il modello deve leggere, e il modo più rapido di farlo leggere troppo è farlo lavorare a giri. Una chat che usa strumenti legge tutto, decide di chiamare uno strumento, riceve il risultato, e per decidere il passo successivo rilegge tutto da capo, più il risultato. La nostra chat può fare fino a tre giri di strumenti, più un giro finale di sola scrittura, e due o tre giri per turno erano normali.
Misurato sul nostro banco di prova, lo stesso messaggio ha fatto leggere al modello circa 70.000 token di prompt nei due giri della chat classica. Con l'architettura nuova, in cui strati specializzati decidono prima e il modello scrive una volta sola, senza strumenti, la voce ne legge circa 2.800: circa venticinque volte meno, per la stessa risposta. Non viene tutto dall'eliminare i giri. Una parte viene dal copione: invece di ricevere la persona intera e decidere da sé cosa ignorare, il modello riceve solo le sezioni che quel turno usa. Su dodici frasi fisse, introdurre il copione ha portato i token di prompt della voce da 4.290 a 2.805 in mediana, circa un terzo in meno, e la risposta completa da 2,73 a 1,61 secondi. Meno da leggere vuol dire anche una prima parola che arriva prima.
Cosa cambia il prompt caching
I fornitori di modelli permettono di marcare una parte del prompt come prefisso stabile: se il turno successivo comincia con lo stesso prefisso, quella parte non si rielabora da zero, si legge dalla cache, a una frazione del prezzo. Nella nostra chat il prefisso è il sistema: persona, regole, conoscenza, strumenti. È identico per ogni turno di ogni persona, quindi è il candidato perfetto.
Contano due dettagli. Il primo è l'ordine del prompt: la cache funziona sul prefisso, quindi tutto quello che cambia da un turno all'altro, come il contesto della giornata o la memoria della persona, deve stare dopo la parte fissa. Un timestamp messo in cima basta a rendere la cache inutile. Il secondo è la chiave: con alcuni fornitori se ne indica una, e noi usiamo un secchio unico per tutta la produzione, così ogni turno trova caldo il prefisso lasciato dal turno precedente, di chiunque fosse. Nei log ogni chiamata registra separatamente i token in ingresso, quelli letti dalla cache e quelli in uscita, perché hanno tre prezzi distinti. Se la colonna della cache resta vuota, è il primo posto dove guardare.
La cache, però, non cancella il problema dei giri: rende più economico rileggere, non elimina la rilettura. E non tocca il tempo che il modello passa a ragionare. I modelli che «ragionano» prima di rispondere scrivono token di ragionamento, e quei token si pagano come token in uscita, la voce più cara. Sul nostro banco un modello impostato senza ragionamento, che sul fornitore non si spegne davvero, ha speso 1.786 token di ragionamento e 16,7 secondi prima della prima parola, per una risposta di poche frasi. Per questo la voce della nostra architettura nuova è piatta di norma: le decisioni le hanno già prese gli strati prima. Diventa profonda, con il ragionamento previsto dall'abbonamento, solo quando serve davvero: la persona chiede di approfondire, il messaggio è ambiguo, o c'è un calcolo sui suoi dati da spiegare. È una scelta di qualità prima che di costo, ma il costo segue.
Lo stesso ragionamento vale per i modelli. Non tutti i lavori di un'app AI sono uguali, e nell'app i ruoli sono tre: main, la voce che la persona legge a ogni turno; secondary, sedici lavori di fondo come estrarre ricordi, compattare la conversazione, scrivere i riassunti e l'analisi della giornata; vision, che legge le foto dei pasti. Gli abbonamenti saranno due, Expert e Pro. L'idea iniziale era un modello per Expert e uno più forte per Pro, ma non regge: togliere il ruolo secondary al primo abbonamento vorrebbe dire togliergli memoria e riassunti. Così ogni ruolo ha un modello per ogni abbonamento, scelto dal pannello: Pro può avere una voce più forte senza che Expert perda i lavori di fondo, e il costo di ogni abbonamento si controlla ruolo per ruolo.
Quanto costa davvero un abbonato?
Per saperlo leggiamo i log delle chiamate, persona per persona: token non in cache, in cache, in uscita, e il costo. Il costo si divide per i giorni in cui la persona era presente nella finestra, mai meno di sette, così chi è arrivato ieri non conta sette volte il suo primo giorno. Le persone si ordinano per consumo e si dividono in cinque fasce.
Con i dati di fine settembre, pochissime persone e una finestra di dieci giorni, ripagando tutto al listino del modello principale, la differenza fra le fasce è la cosa che colpisce: la più pesante costava circa cinque volte la mediana. Sono numeri di un'app ancora in beta e cambieranno, ma bastano a capire dove guardare quando si ragiona sul margine: non la persona media, ma le fasce alte.
Quei numeri sono puliti solo perché abbiamo tolto la parte sporca. Tra fine agosto e metà settembre un utente di test automatico aveva bruciato un centinaio di milioni di token, e si provavano modelli cari. Con quei giorni dentro, la media saliva di quasi venti volte, oltre il prezzo di un abbonamento. Prima di fare conti sul costo per utente bisogna separare chi sviluppa e chi prova da chi usa l'app. E due ultime cose rendono il conto realistico: il costo dei modelli si paga per ogni abbonato attivo e per chi è nel periodo di prova, perché anche loro usano l'app; e dal prezzo di un abbonamento, prima di arrivare al margine, si tolgono l'IVA e la commissione dello store, quindi il costo dei modelli va confrontato con quello che resta, non con il prezzo di listino.
In sintesi:
- In una chat AI il costo sta nei token letti, non in quelli scritti: si riduce facendo leggere meno al modello.
- Ogni giro con strumenti rilegge tutto il prompt: due giri possono far leggere venticinque volte i token di un giro solo con un prompt mirato.
- Il prompt caching funziona solo se la parte fissa sta in cima e non cambia mai; i log devono dire quanto viene davvero dalla cache.
- Il ragionamento si paga come scrittura: va acceso quando serve, non sempre.
- Un modello per ruolo e per abbonamento, e il costo per abbonato misurato sui log, al netto degli account di test.