 Sweet Pal
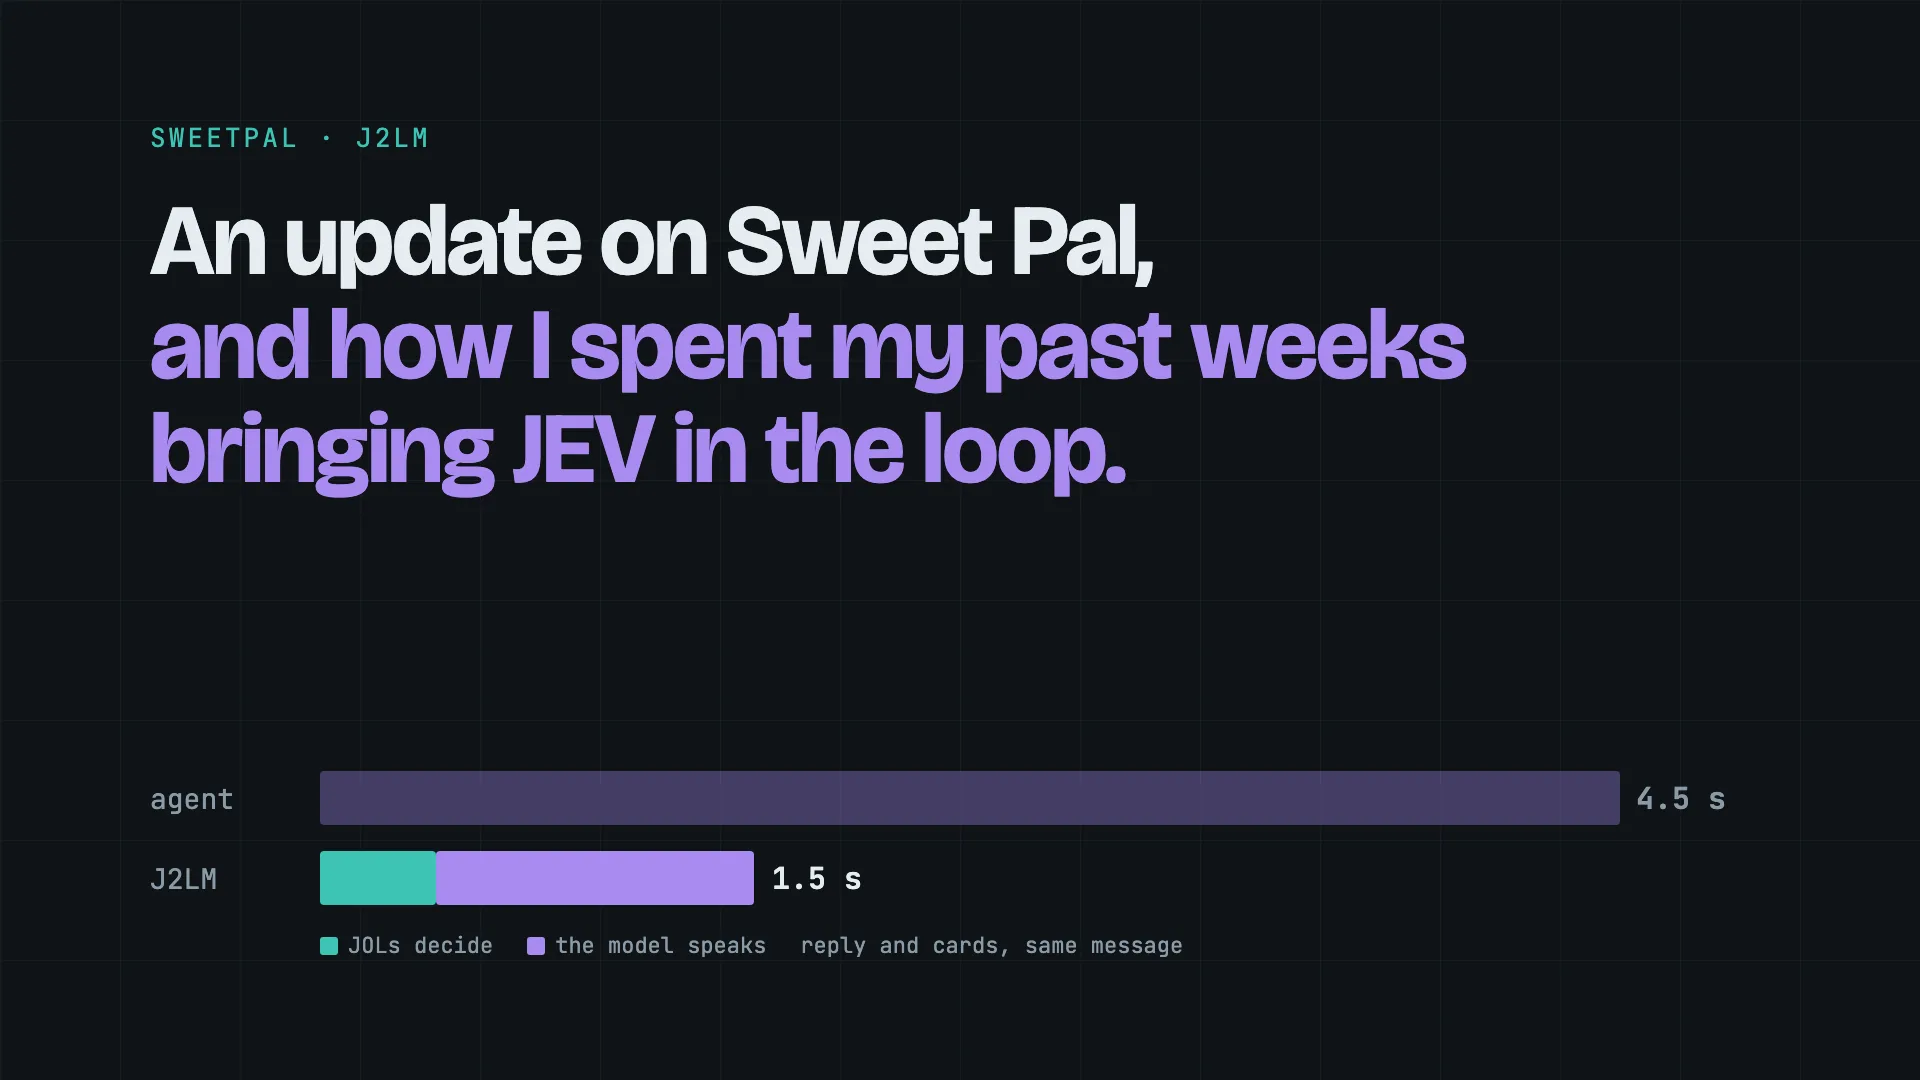
Come abbiamo tolto al modello linguistico il lavoro che non avrebbe mai dovuto fare, e portato le risposte della chat di Sweet Pal sotto il secondo e mezzo.
Sweet Pal è un compagno per chi vive con il diabete. Scrivi «ho appena mangiato una pizza» e deve fare tante cose insieme: capire che è un pasto da registrare, preparare la card, ricordare come quel cibo ha mosso la tua glicemia le ultime volte, decidere se suggerirti qualcosa o lasciarti in pace, e rispondere con una frase che suoni umana. Fino a qualche settimana fa faceva tutto un unico modello linguistico.
Funzionava. Ma era lento, e in questa app la lentezza pesa più che altrove. Chi scrive ha appena mangiato, o ha appena visto la glicemia scendere. Aspettare dieci secondi davanti a tre puntini che lampeggiano non è un dettaglio di prestazioni. Sembra di non essere ascoltati.
Il problema: un modello che pensa ad alta voce
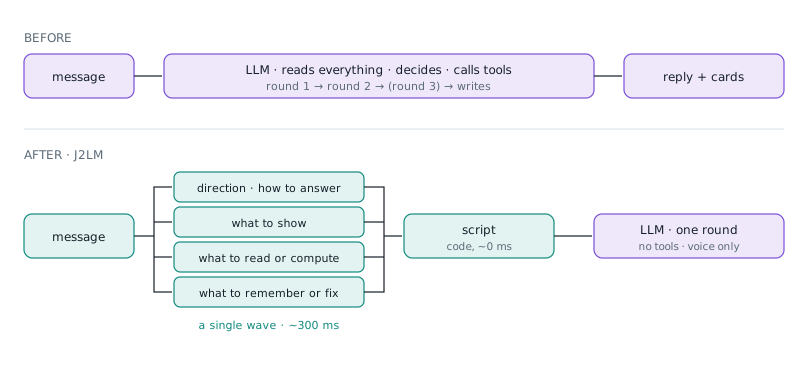
Ogni messaggio arrivava all'LLM con un prompt enorme: chi è Sweet Pal, le regole di sicurezza, le conoscenze cliniche di base, il manuale di più di trenta strumenti. Il modello leggeva tutto, decideva quali strumenti chiamare, aspettava i risultati, a volte richiamava, e solo alla fine scriveva. Due o tre giri per turno erano la norma.
Il punto è che quasi tutto quel lavoro non era linguaggio. Era classificazione. È un pasto o una domanda? Qui serve la card del bolo? La persona è in difficoltà? Sono domande a risposta chiusa, e le stavamo facendo risolvere al componente più lento e più caro del sistema, nel modo più caro possibile: in prosa, ragionando.
L'idea: separare il decidere dal dire
La svolta è stata JEV, il modello «System One» di TypeSafe. JEV non scrive testo. Prende un contenuto e un insieme di domande tipizzate, e risponde a tutte insieme, in parallelo, con dei valori: un'opzione fra tante, un livello su una scala, la probabilità che un'affermazione sia vera. In circa un quarto di secondo.
Sopra JEV abbiamo costruito uno strato Operator: i JOL, JEV Operator Layer. Un JOL è un gruppo di domande atomiche più un insieme di regole, scritte in chiaro, che trasformano le risposte in una decisione. JEV dice che cosa è vero; le regole dicono che cosa fare; una soglia di confidenza dice quanto fidarsi. Il modello linguistico arriva solo alla fine, quando tutto è deciso, e fa l'unica cosa che sa fare meglio di chiunque: parlare.
Abbiamo chiamato l'architettura J2LM: prima i JOL, poi l'LLM.
Un'onda, non una catena
All'inizio i JOL lavoravano in fila: un primo strato di smistamento passava la mano agli specialisti. Misurando, ci siamo accorti che il primo strato passava la mano sempre a tutti, qualunque cosa rispondesse. Aspettarlo era metà del tempo dei JOL, speso per sapere una cosa che sapevamo già.
Oggi il motore riconosce le decisioni che non dipendono dalle risposte e lancia tutto in un'unica onda. Gli specialisti sono quattro: cosa mostrare, cosa leggere, cosa calcolare, cosa ricordare o correggere. Accanto a loro c'è lo strato di regia, che capisce come rispondere. Il tempo mediano dei JOL è sceso da circa 580 a circa 290 millisecondi.
Come si costruisce un JOL
Scrivere domande per JEV sembra facile, e non lo è. Una domanda sembra sempre chiara a chi l'ha appena scritta. Alcune regole le abbiamo imparate a nostre spese.
- Una domanda, una cosa. Una sola domanda composta («serve leggere i dati o le fonti?») mancava casi ovvi. Divisa in tre domande atomiche di una riga, ha azzeccato tutte le frasi di prova.
- Ogni specialista è padrone del suo «niente». Un cancello davanti che indovina «serve uno specialista?» rifà, male, un lavoro che lo specialista fa già bene. Meglio chiedere a tutti e lasciare che ognuno dica «non è roba mia».
- Prima il test, poi l'attivazione. Nessuna versione va in produzione senza aver superato, contro il modello vero, un insieme di frasi di riferimento. Le versioni vecchie non si cancellano mai: si spengono e restano lì per il confronto.
- Potare. Lo strato di regia aveva dodici registri per descrivere cosa sta facendo la persona. Ne abbiamo tolti quattro, perché quelle distinzioni le facevano già gli specialisti. Con meno opzioni JEV è diventato più sicuro: nei nostri test la confidenza minima è passata da 0,36 a 0,55, e ogni frase è stata classificata correttamente.
- La sicurezza ha due porte. «Sono a 62, sto bene, mi capita sempre» veniva letta come un racconto. Una domanda atomica sul valore a rischio, che scavalca tutto il resto, la trasforma in quello che è: un'emergenza. Qui sbagliare per eccesso di prudenza costa poco; sbagliare dall'altra parte no.
Il copione: l'ultimo strato
Il primo J2LM era già più veloce dell'app, eppure il modello ci metteva ancora più del necessario. I JOL decidevano, ma non dicevano al modello come parlare. Riceveva la persona intera e una lista di card, e capiva da solo se era un'emergenza, un saluto o qualcuno che si sfoga, quanto essere lungo, se chiudere con una domanda.
Un JOL non può essere l'ultimo strato, perché JEV non scrive. L'ultimo strato è codice: il copione. Dalle risposte della regia e dalle decisioni degli specialisti sceglie quali parti della persona servono a questo turno, quante frasi scrivere, cosa dire di ogni card e cosa non dire, e se chiudere con un suggerimento. Al modello resta soltanto il linguaggio.
Prima il modello riceveva tutto e decideva cosa ignorare. Adesso riceve solo quello che deve usare.
- −41%
- tempo mediano di risposta completa, su un insieme fisso di frasi
- −35%
- token di prompt della voce, dopo l'arrivo del copione
- ~25×
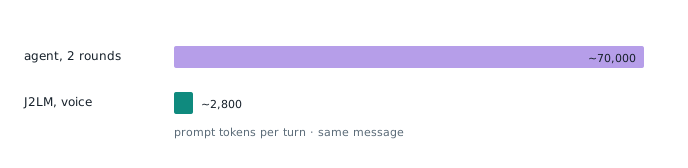
- meno token letti per turno rispetto all'agente a più giri
Il numero che conta è il primo
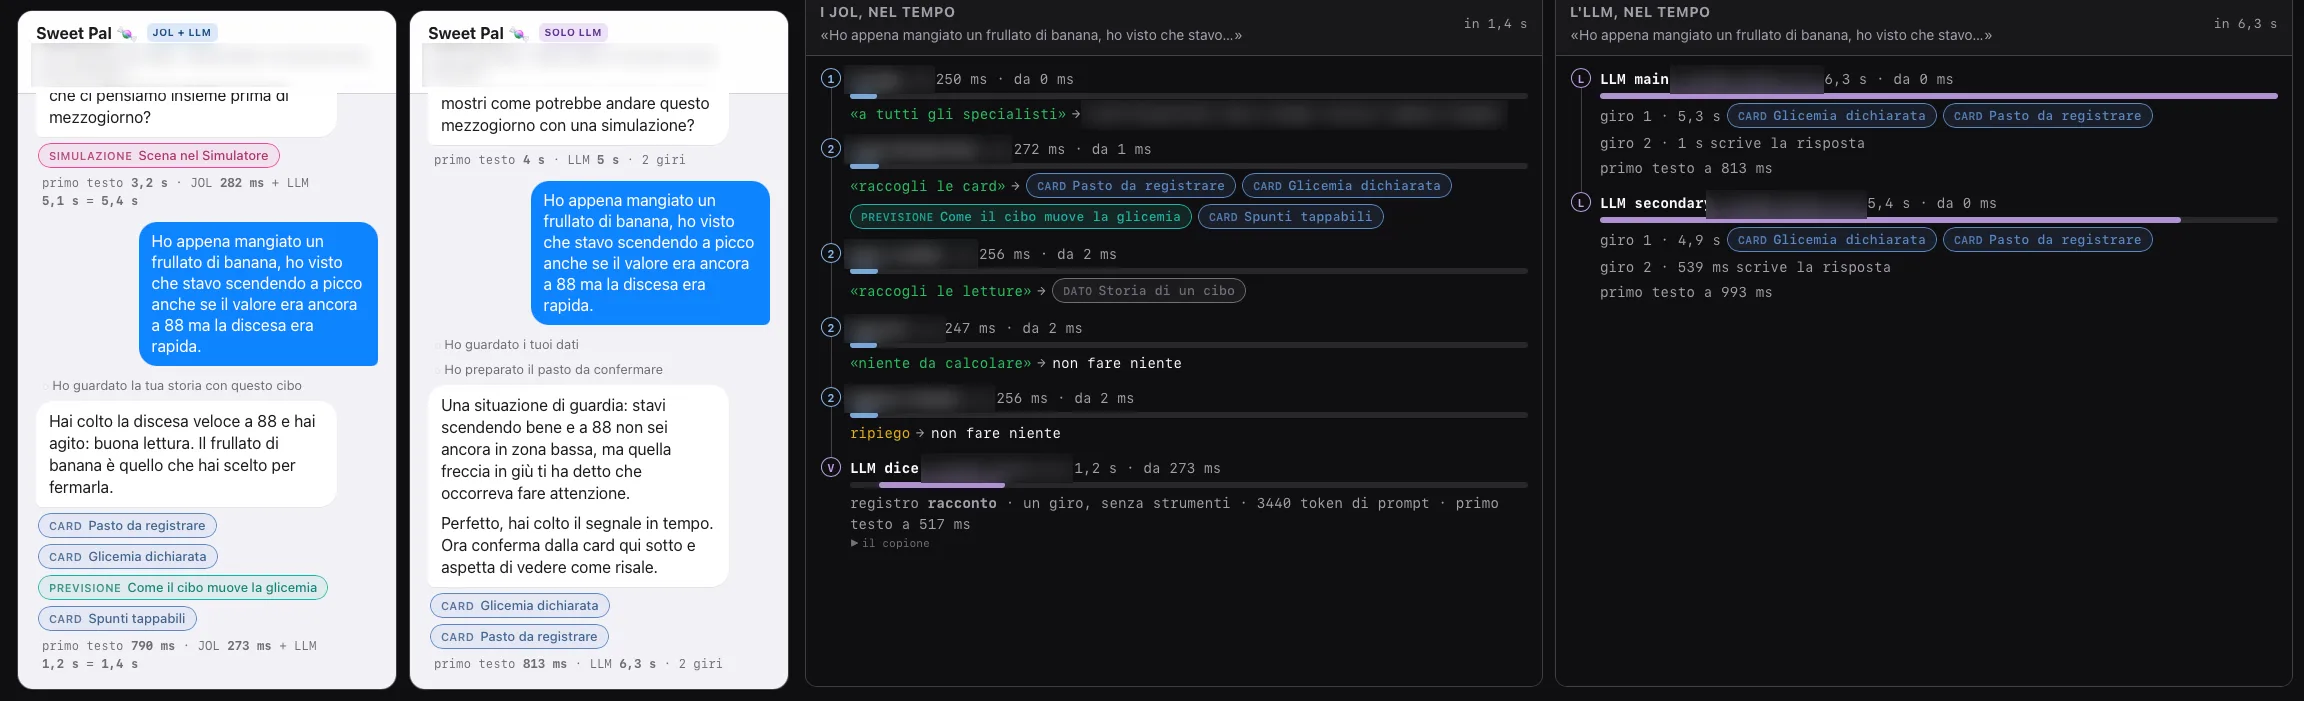
Per settimane abbiamo misurato il tempo totale. Poi abbiamo portato nel nostro banco di prova lo stesso streaming che usa l'app, e abbiamo cominciato a misurare quello che la persona sente davvero: il momento in cui la nuvoletta comincia a riempirsi. Lo chiamiamo primo token, ed è risultato il numero più istruttivo di tutti.
In una misura della voce di J2LM, il primo testo arrivava a 1,7 secondi su 2,1 della risposta completa. Quasi tutto il tempo del modello è attesa prima di cominciare, non scrittura. Questo ha spostato il lavoro: per andare più veloci non serviva che il modello scrivesse meno, serviva che leggesse meno e pensasse meno prima di aprire bocca.
Indipendente dal ragionamento
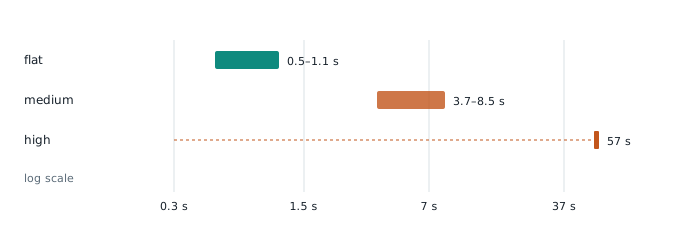
I modelli di oggi possono «ragionare» prima di rispondere, e questo costa tempo. Nella chat classica è un prezzo che vale la pena pagare, perché il modello deve decidere tutto. In J2LM la decisione è già presa. Abbiamo misurato cosa succede se la voce ragiona comunque: con un livello di ragionamento medio il primo testo passa da circa un secondo a quattro-otto. Con un livello alto, in un caso, il modello ha pensato 57 secondi per scrivere quattro frasi che il copione aveva già impostato. E le ha scritte peggio.
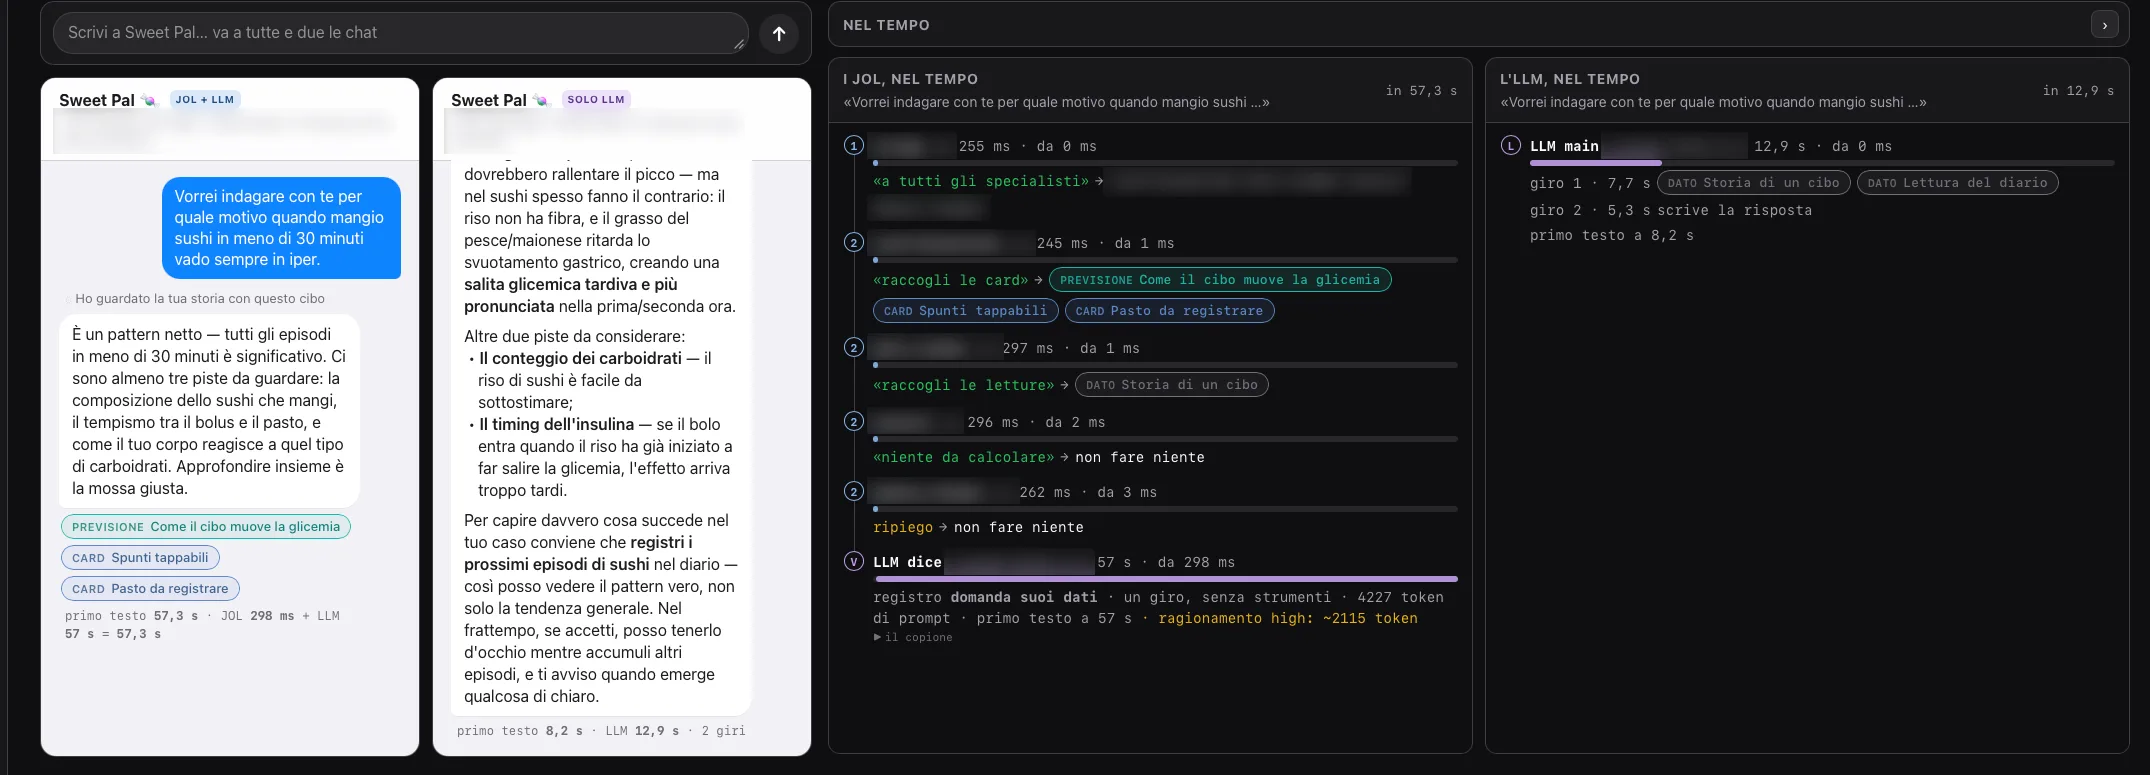
Da qui la regola che adesso chiamiamo main a due velocità. La voce di J2LM è piatta, senza ragionamento, quasi sempre. Diventa profonda, con il livello di ragionamento previsto dall'abbonamento, solo quando lo chiedono i JOL: la persona vuole approfondire, la regia non è riuscita a leggere il messaggio, oppure c'è un calcolo sui suoi dati da spiegare. Non è più il modello a decidere quanto pensare. È l'architettura.
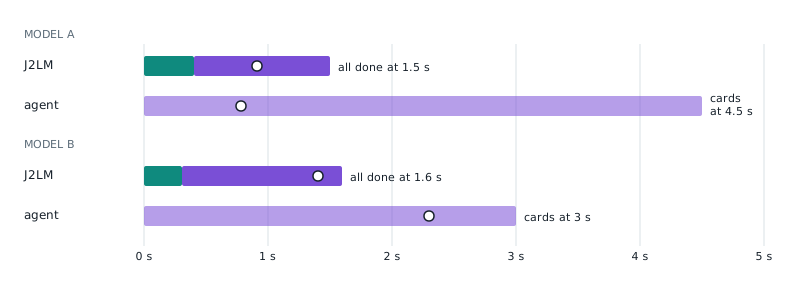
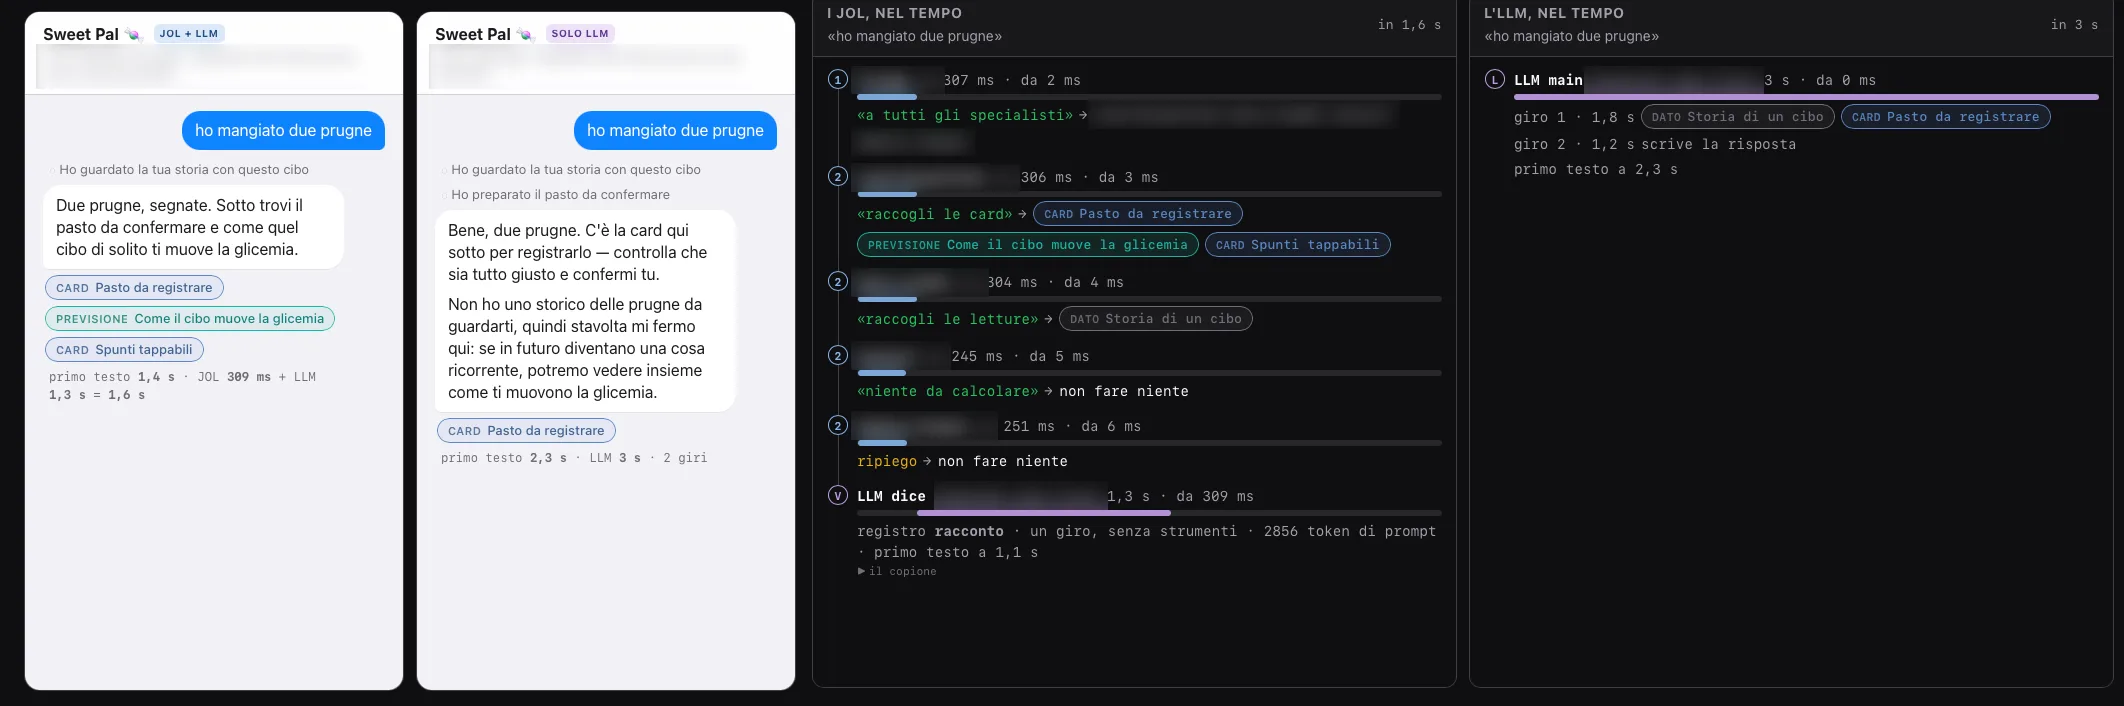
C'è un effetto collaterale prezioso. La velocità della chat non dipende più da quanto piacerà ragionare al modello di domani. Due modelli molto diversi, uno aperto e uno proprietario, hanno chiuso entrambi un pasto raccontato, risposta e card comprese, in circa un secondo e mezzo.
I costi
Un turno di chat classica legge decine di migliaia di token di prompt, e quando il modello fa due giri li legge due volte. Un turno di J2LM legge il copione e la fetta di persona che gli serve: tre-quattromila token in un giro solo, più una chiamata a JEV che costa una frazione. Ogni token non letto è tempo risparmiato prima del primo token, e una riga in meno in fattura.
Cosa manca ancora
Oggi J2LM sceglie le card ma non le riempie, e gli specialisti decidono cosa leggere ma la lettura dei dati veri è ancora da collegare. La chat classica quel lavoro lo fa già, quindi una parte del vantaggio viene da lavoro che J2LM non ha ancora cominciato. Il prossimo strato è proprio questo: estrarre i valori, leggere i dati, calcolare, prima che la voce parli. Lo misureremo sullo stesso banco di prova, perché è l'unico modo per sapere se il vantaggio regge.
Una lezione però è già acquisita. Un modello linguistico è uno strumento straordinario per dire le cose, e uno strumento lento e costoso per decidere cose che hanno una risposta chiusa. Separare le due ci ha restituito il tempo che meritano le persone che usano Sweet Pal.
I numeri vengono dal nostro banco di prova interno, che riproduce la chat dell'app con lo stesso prompt, gli stessi fornitori e lo stesso streaming. Sono mediane su insiemi fissi di frasi, ottobre 2026.