 Sweet Pal
Valutare un LLM prima di accenderlo, per noi, vuol dire tre cose: farlo rispondere a un insieme fisso di frasi di riferimento usando il modello vero, non una sua imitazione; tenere ogni versione precedente spenta ma intatta, per poterla rimettere accanto alla nuova; e misurare il tempo che la persona sente davvero, cioè quando compare la prima parola. Nessuna delle tre è complicata. Saltarne una, però, ci è costato ogni volta un errore che avremmo potuto vedere prima.
In Sweet Pal la chat non è una sola chiamata a un modello. Prima che il modello scriva, una serie di strati decide cosa mostrare, cosa leggere, cosa calcolare e con che tono rispondere. Ognuno di questi strati è fatto di domande scritte a mano e di regole. E una domanda scritta a mano sembra sempre chiara a chi l'ha appena scritta.
La prima lezione è arrivata proprio da una domanda che sembrava ovvia: «serve leggere i dati o le fonti?». Una domanda sola, composta, che doveva accorgersi di quando una persona chiede qualcosa sulla propria storia. Messa alla prova su frasi vere, perdeva casi che chiunque avrebbe preso: i pancakes di domani mattina, una domanda sull'indice glicemico, una corsa. Le probabilità restituite erano 0,28, 0,18, 0,27: tutte sotto soglia. Divisa in tre domande atomiche, una riga ciascuna, ha preso 12 frasi su 12, con risposte nette: sopra 0,63 o sotto 0,11. Nessuno di noi avrebbe previsto la differenza leggendo il testo. L'ha mostrata il set di frasi.
Da lì è nata la regola che usiamo per ogni comportamento nuovo: prima le frasi, poi l'attivazione. Un insieme di frasi di riferimento, scritte come le scriverebbe una persona vera, con la risposta attesa accanto. Il set cresce ogni volta che troviamo un caso sbagliato: quel caso diventa una frase, e da quel momento ogni versione futura deve superarla.
L'esempio a cui teniamo di più riguarda la sicurezza. La frase «sono a 62, mi sento bene, mi capita sempre» veniva letta come un racconto qualunque. Per chi vive con il diabete di tipo 1 è un valore basso che merita attenzione anche se la persona dice di stare bene. La domanda che doveva riconoscerlo rispondeva 0,04. Riscritta, risponde 0,89, e il gruppo di frasi su quel tema passa 13 su 13. Quella frase ora sta nel set per sempre.
Ogni comportamento lo proviamo in due modi, perché rispondono a domande diverse. A mano si provano le regole: si scrivono con dei cursori le risposte che il modello darebbe e si guarda cosa decide lo strato, con sotto una traccia regola per regola che dice quale condizione è fallita e con che valore. Serve perché dal vivo non si riesce a far capitare una confidenza di 0,69 quando la soglia è 0,70, e le soglie si provano solo al limite. Dal vivo, invece, si provano le domande: una frase vera va al modello vero e si leggono le risposte con le loro distribuzioni. È l'unico modo per sapere se una domanda separa davvero i casi che deve separare.
C'è un corollario che abbiamo imparato due volte: il banco di prova deve chiedere al modello esattamente quello che chiede la produzione. Per qualche settimana il nostro non specificava se il modello dovesse ragionare prima di rispondere, e un modello lasciato libero ragionava di suo: sette secondi a giro invece di due o tre. Più tardi è successo il contrario: un altro modello, che in produzione ragiona sempre, sul banco rispondeva senza ragionare e sembrava veloce quanto quelli spenti. In entrambi i casi i numeri erano veri e la conclusione sbagliata. Oggi il banco copia dalla produzione il prompt, gli strumenti, il modo di chiedere il ragionamento e la cache, e lo streaming. Quando la chat dell'app cambia, uno script ricopia tutto, e la pagina dice da quale versione dell'app è stato copiato.
Versioni che si spengono, mai cancellate
Ogni strato ha delle versioni, e una sola alla volta è attiva. Non lo garantisce l'interfaccia, lo garantisce un vincolo del database: due versioni attive dello stesso strato non possono esistere. Le versioni vecchie non si cancellano. Si spengono e restano lì, selezionabili dal banco di prova, perché «la nuova è migliore» è un'affermazione che va dimostrata contro qualcosa, e quel qualcosa deve essere ancora eseguibile, non un ricordo.
L'esempio più recente è lo strato che decide il registro della risposta: urgenza, sfogo, racconto, domanda e così via. La versione precedente aveva dodici opzioni e sul suo set faceva 18 frasi su 20, con una confidenza minima di 0,36. Ne abbiamo tolte quattro, perché altri strati facevano già quelle distinzioni. La nuova, su 31 frasi, le prende tutte, con una confidenza minima di 0,55. Lo sappiamo perché la vecchia è ancora lì, accanto, sulle stesse frasi.
Prima dell'attivazione c'è anche un controllo automatico, a due livelli. Gli errori bloccano, perché il modello rifiuterebbe la richiesta o la decisione non può funzionare: una scelta con una sola opzione, una regola che cita una domanda che non esiste. Gli avvisi non bloccano ma segnalano qualcosa che quasi certamente non fa quello che si voleva, e si possono ignorare: a volte si sta ancora scrivendo.
Il pezzo che ha cambiato di più il nostro modo di lavorare, però, è il banco affiancato. Si scrive un messaggio una volta sola, e parte nello stesso istante verso due chat: a sinistra la nuova architettura, a destra la chat che l'app usa oggi. Sotto ogni risposta ci sono i tempi; di lato, una linea del tempo che mostra quale strato è partito quando e quanto è durato.
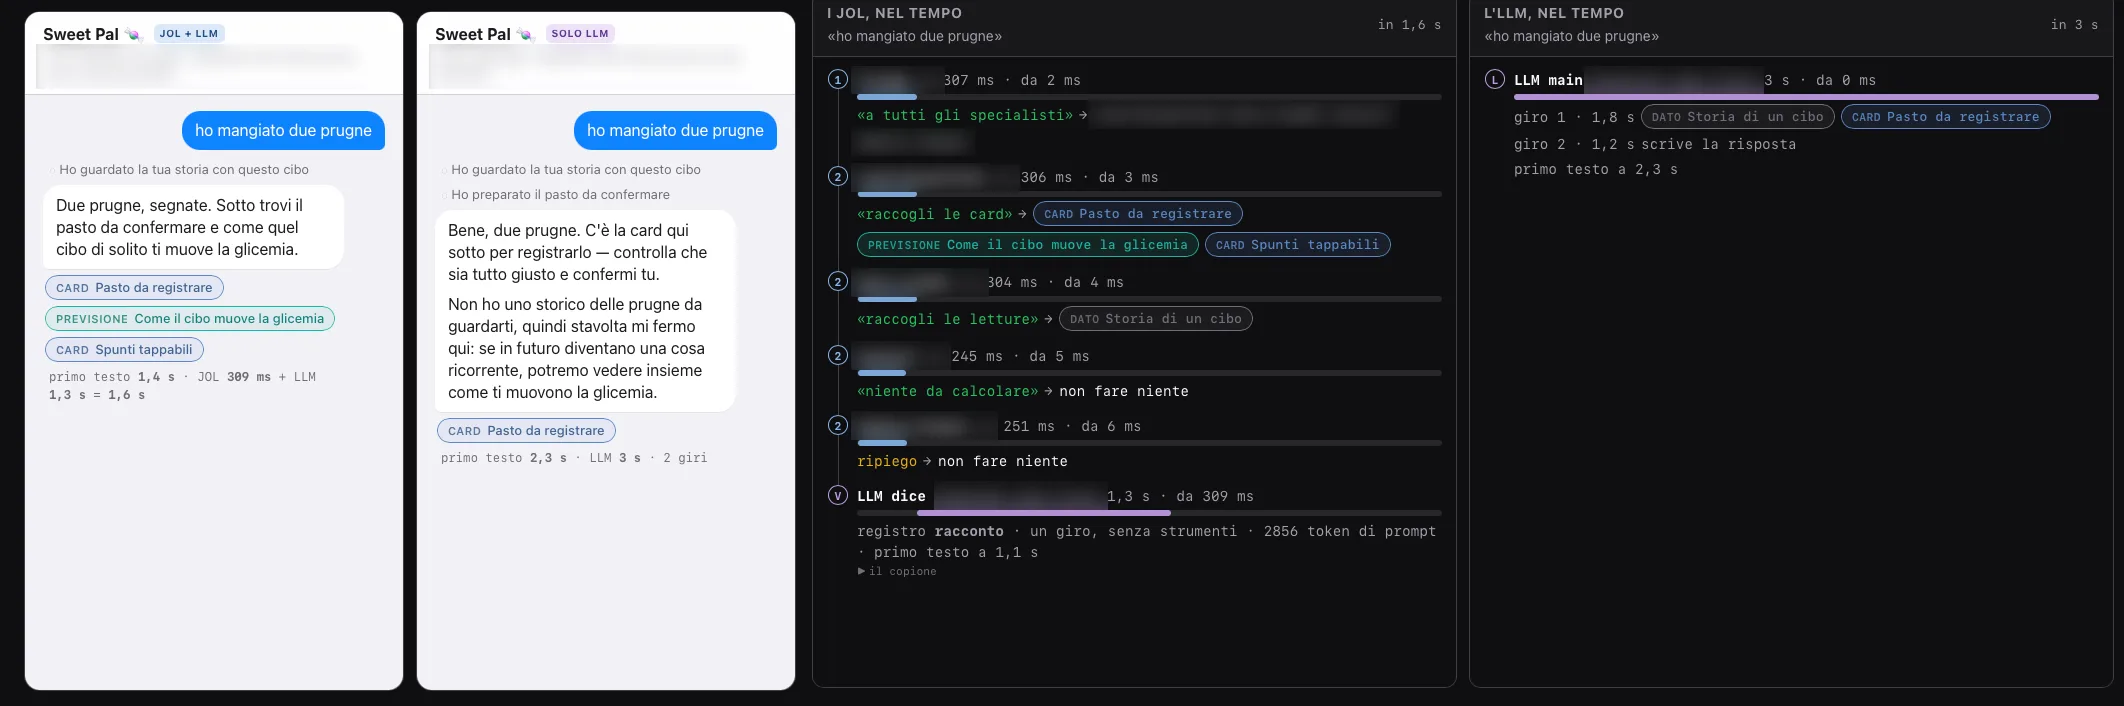
Vedere due risposte una accanto all'altra mette in evidenza difetti che un numero da solo nasconde. Nelle prime prove la nuova versione era più veloce, ma a volte elencava le card invece di accennarle, o affermava una tendenza nei dati che non aveva visto. Sono diventate regole del copione, e frasi nel set. Il banco ci obbliga anche all'onestà sui confronti: oggi la nuova architettura sceglie le card ma non le riempie ancora, e non legge ancora i dati della persona, mentre la chat di oggi quel lavoro lo fa. Una parte del vantaggio di velocità viene da lavoro che manca. Lo scriviamo accanto ai numeri, e il confronto definitivo lo faremo quando le due chat faranno la stessa quantità di lavoro.
Il primo token, non solo il totale
Per settimane abbiamo misurato il tempo totale di risposta. Poi abbiamo portato nel banco lo stesso streaming dell'app e abbiamo cominciato a misurare il momento in cui la bolla inizia a riempirsi: il primo token. In una misura della voce, il primo testo arrivava a 1,74 secondi su 2,13 totali. Quasi tutto il tempo del modello era attesa prima di cominciare, non scrittura. Questo ha spostato il lavoro: per andare più veloci non serviva far scrivere meno il modello, serviva fargli leggere meno e pensare meno prima di aprire bocca.
Due abitudini rendono questi numeri utili. La prima: mediane su un set fisso. Lo stesso turno, con lo stesso numero di token, ha impiegato 1,1 secondi in un giro e 3,5 in un altro, per la sola variabilità del fornitore; un confronto su una frase sola non dice niente, mentre su dodici frasi fisse la mediana è passata da 2,73 a 1,61 secondi. La seconda: il tempo per strato. La linea del tempo separa il tempo delle decisioni da quello del modello, e si vede subito dove cercare il guadagno: nel nostro caso le decisioni sono scese da circa 580 a circa 290 millisecondi, ma il grosso stava nel modello.
Non tutto è a posto. Le prove non si salvano, e il confronto fra due stesure si rifà a mano. Il cuore delle regole è codice puro e senza dipendenze, quindi il primo candidato per dei test automatici, ma i test ancora non ci sono. E il set di frasi vive in parte nei documenti di lavoro, non ancora in un posto solo da cui farlo girare con un comando. Sono le prossime cose da fare, nell'ordine.
In sintesi:
- Un comportamento AI si valuta su un set fisso di frasi di riferimento, con il modello vero; ogni errore trovato diventa una frase nuova.
- Il banco di prova deve chiedere al modello esattamente quello che chiede la produzione, ragionamento compreso, o i numeri ingannano.
- Le versioni vecchie si spengono e non si cancellano: «meglio» si dimostra solo contro qualcosa che si può ancora eseguire.
- Due chat affiancate sullo stesso messaggio mostrano difetti che un numero da solo nasconde.
- Si misura il primo token, con mediane su frasi fisse: è il tempo che la persona sente.