 Sweet Pal
Un prodotto AI indipendente dal modello si costruisce con tre scelte: i fornitori parlano tutti attraverso la stessa interfaccia, il modello di ogni ruolo si sceglie da una riga di database e non con un deploy, e le decisioni che contano vengono tolte al modello e affidate all'architettura. Così, quando un modello cambia, sparisce o si comporta in modo diverso, il prodotto resta lo stesso. È quello che abbiamo imparato costruendo Sweet Pal.
I modelli linguistici cambiano a una velocità che nessun altro componente di un'app ha. Ogni mese ne esce uno più rapido, più economico o più bravo in qualcosa. Se il prodotto è scritto attorno a un modello preciso, ogni novità diventa un piccolo trasloco; se il modello è un pezzo sostituibile, la novità è un'opportunità da provare in un pomeriggio. E soprattutto il modello non è sotto il tuo controllo: il fornitore decide quando aggiornarlo, quando ritirarlo e come cambiano i suoi parametri.
Ce ne siamo accorti nel modo più concreto possibile. A fine settembre il ruolo che in Sweet Pal fa i lavori di fondo, cioè estrarre i ricordi dalla conversazione, compattare le chat lunghe, scrivere le analisi, ha cominciato a fallire. La configurazione era giusta: era il fornitore ad aver smesso di servire quel modello, una versione datata di quelle che prima o poi vengono ritirate. Il catalogo continuava a elencarlo, ma alla chiamata rispondeva «non disponibile». Quel giorno sono fallite cinque estrazioni di memoria, tre compattazioni e un'analisi. La lezione non è «scegli meglio il fornitore». È che un modello in catalogo non è un modello che risponde, e che il prodotto deve poter cambiare modello in pochi minuti, senza rilasciare niente.
Per questo Sweet Pal oggi parla con tre fornitori senza che il resto del codice lo sappia. Due usano lo stesso formato di API, il terzo ne ha uno suo, ma tutti stanno dietro una sola funzione che riceve la conversazione, gli strumenti disponibili e il tetto di output, e restituisce testo, eventuali chiamate a strumento e i conteggi dei token. Dentro quella funzione vivono tutte le differenze: come si compone la richiesta, come si legge lo streaming, come si rimandano i blocchi di ragionamento al giro successivo quando un fornitore lo richiede. Aggiungere un fornitore significa scrivere un adattatore, non riscrivere la chat.
Il modello si sceglie da database, non da deploy
In Sweet Pal i modelli non stanno nel codice e nemmeno nelle variabili d'ambiente. Stanno in una tabella: per ogni ruolo (la chat, i lavori di fondo, la lettura delle immagini) c'è una riga con il modello, il livello di ragionamento e la temperatura. Cambiare modello vuol dire modificare quella riga dal pannello interno, e il messaggio successivo parte già sul modello nuovo. Da qualche settimana la tabella ha anche una dimensione in più, l'abbonamento: ogni ruolo può avere un modello per Expert e uno per Pro, così il turno di chat di chi paga di più può usare un modello più forte senza toccare una riga di codice.
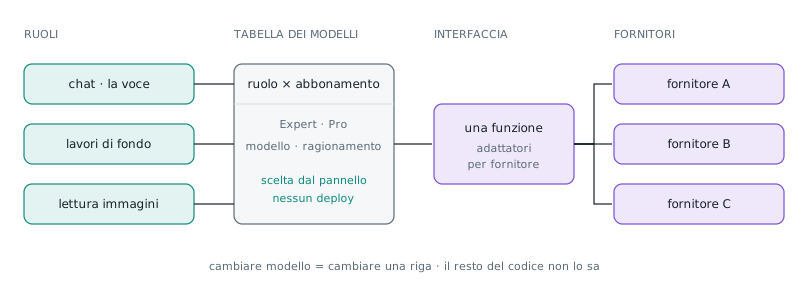
Tre regole rendono sicura questa flessibilità. La prima: il codice controlla la forma, non l'elenco. Una lista dei modelli ammessi scritta nel codice costringerebbe a un deploy per aggiungerne uno, proprio ciò che vogliamo evitare; il codice verifica invece che il fornitore sia uno dei nostri e che il nome del modello abbia una forma valida, e basta questo a impedire che una riga scritta male mandi il traffico altrove. La seconda: una lettura per turno. La configurazione si legge una volta all'inizio e il modello risolto viaggia come un oggetto fino alla fine; se la si rileggesse a metà, il modello che ha risposto e quello a cui viene addebitato il costo potrebbero non coincidere. La terza: nessun modello di riserva. Sembra gentile ripiegare su un modello scritto nel codice quando il database non risponde, ma un modello di riserva non ha un listino, una chiamata senza listino costa zero, e una chiamata che costa zero non muove il contatore della spesa: un singhiozzo del database trasformerebbe il tetto di consumo in niente. Meglio un errore che si vede. Dopo l'episodio di settembre abbiamo aggiunto anche un pulsante «prova» accanto a ogni scelta di modello, che fa una chiamata minima al fornitore prima di applicare la modifica: se il modello non è servito, lo si scopre lì e non dai log del giorno dopo.
Un'interfaccia comune, però, non rende i modelli uguali, e il punto in cui le differenze si sentono di più è il ragionamento, il tempo che il modello passa a pensare prima di scrivere. Ogni fornitore lo controlla a modo suo, e a volte lo cambia da una generazione all'altra. Un modello aperto, se non gli si dice esplicitamente di non ragionare, ragiona lo stesso: con il ruolo impostato a «nessun ragionamento» un giro passava da due o tre secondi a sette. In una famiglia di modelli il ragionamento «a budget» funzionava sulle versioni vecchie e sulle nuove restituisce un errore. Per spegnerlo, un modello accetta «disattivato», un altro rifiuta quella parola e ne vuole un'altra, un terzo non si spegne mai e si può solo portare al livello più basso; un altro ancora, senza un budget, tornava con una risposta vuota. Nessuna di queste è una scelta di prodotto: sono dettagli di fornitore, e vivono tutti accanto all'adattatore. Il resto del sistema chiede «voce piatta» o «ragiona a livello medio», e l'adattatore traduce nella forma che quel modello accetta. Quando un fornitore cambia le regole si corregge una funzione, non dieci.
Togliere le decisioni al modello
La scelta che ci ha reso davvero indipendenti dal modello, però, è un'altra. In J2LM, l'architettura che abbiamo raccontato in Prima decidere, poi parlare, le decisioni non le prende più il modello linguistico. Le prendono livelli specializzati che rispondono a domande chiuse, in parallelo, in circa trecento millisecondi; un copione scritto in codice traduce le loro scelte in istruzioni; il modello scrive soltanto, in un giro solo e senza strumenti. Se il modello deve solo dare voce a decisioni già prese, il suo talento nel ragionare conta molto meno. Lo abbiamo visto misurando: due modelli molto diversi, uno aperto e uno proprietario, hanno chiuso lo stesso pasto raccontato, risposta e card comprese, in circa un secondo e mezzo ciascuno. Con l'agente classico, che decideva tutto da solo, gli stessi due modelli consegnavano le card a 3 e a 4,5 secondi.
Lo stesso principio vale per quanto il modello deve pensare. Se lo decide il modello, la velocità della chat dipende da quanto gli piace ragionare, e ogni modello nuovo ha un carattere diverso. Per questo la voce di Sweet Pal ha due velocità: di norma è piatta, con il ragionamento spento davvero nella forma che ogni modello accetta, e diventa profonda, con il livello previsto dall'abbonamento, solo quando sono i livelli di decisione a chiederlo, perché la persona vuole andare a fondo, il messaggio non è stato capito con sicurezza o c'è un calcolo sui suoi dati da spiegare. Con lo stesso modello a livello medio, la voce piatta comincia a scrivere in 0,9–1,4 secondi, quella profonda in 7,5–8. Il modello non decide più quanto pensare: lo decide il prodotto, nello stesso modo qualunque modello ci sia sotto.
Resta un lavoro da fare. Le regole del ragionamento cambiano ancora troppo spesso, e ogni cambio va verificato a mano su un banco di prova che riproduce la chat vera. Il passo successivo è rendere quella verifica automatica: un insieme di frasi di riferimento da far passare a ogni modello prima che possa essere scelto dal pannello.
In sintesi:
- I fornitori stanno dietro una sola interfaccia: le loro differenze vivono negli adattatori, non nel prodotto.
- Il modello di ogni ruolo è una riga di database, controllata nella forma, letta una volta per turno, senza modelli di riserva che sfuggono al conteggio dei costi.
- Un modello in catalogo non è un modello che risponde: prima di cambiarlo, si prova.
- Togliere le decisioni al modello rende il prodotto meno sensibile a quale modello usi.
- Quanto il modello ragiona lo decide l'architettura, non il modello.